随着网页采集应用不断扩大,企业采集的数据来源也在发生变化。过去,搜索引擎、电商平台和社交媒体是网站数据采集的主要目标,而到了2026年,AI平台开始成为新的热门数据来源。
从公开的行业数据来看,2026年的热门采集网站已经覆盖搜索、短视频、电商、AI、开发者平台和自动化工具等多个领域。其中,TikTok继续保持较高的数据采集热度,ChatGPT和Perplexity则首次进入热门网站榜单。
那么,2026年哪些网站最常被采集?不同平台的数据又有什么价值?
一、2026年最常被爬取的网站有哪些?
根据2026年公开的网页抓取行业数据,热门数据采集网站主要包括社媒平台、AI平台、搜索引擎。但需要注意的是,这类排行榜通常来自特定数据集或平台的采集请求统计,并不代表整个互联网所有爬虫请求的绝对排名。因此,更适合将其作为观察2026年数据采集趋势的参考。
从榜单变化来看,最值得关注的并不是某一个网站排名上升或下降,而是数据采集目标正在从传统网站向AI平台和技术平台扩展。
2026年热门数据采集网站
| 排名 | 网站 | 主要数据类型 | 常见应用场景 |
| 1 | TikTok | 视频、账号、Hashtag、评论、互动 | 社交媒体分析、趋势研究 |
| 2 | 搜索结果、关键词、广告、本地结果 | SEO、市场分析、SERP监控 | |
| 3 | ChatGPT | AI回答、品牌提及、引用来源 | GEO、AI搜索分析 |
| 4 | Amazon | 商品、价格、评论、排名、库存 | 电商分析、竞品监控 |
| 5 | 帖子、账号、Hashtag、互动 | 社媒分析、品牌研究 | |
| 6 | 帖子、评论、社区讨论 | 舆情分析、用户研究 | |
| 7 | YouTube | 视频、频道、评论、搜索结果 | 内容分析、市场研究 |
| 8 | 公司、职位、公开资料 | B2B、招聘、销售研究 | |
| 9 | X | 帖子、账号、互动、趋势 | 舆情监测、热点分析 |
| 10 | Walmart | 商品、价格、库存、评论 | 电商监控、价格分析 |
| 11 | eBay | 商品、价格、卖家、评价 | 电商竞品分析 |
| 12 | Bing | 搜索结果、关键词、广告、本地结果 | SEO、SERP监控 |
| 13 | Perplexity | AI回答、引用来源、搜索结果 | GEO、品牌监测 |
| 14 | Etsy | 商品、价格、评论、店铺 | 电商与市场研究 |
| 15 | Crunchbase | 公司、融资、行业信息 | B2B、市场研究 |
| 16 | Airbnb | 房源、价格、评价、位置 | 旅游、价格监控 |
| 17 | GitHub | Repository、Issue、代码、开发活动 | 技术研究、开发分析 |
| 18 | Stack Overflow | 问题、回答、标签、技术讨论 | 技术趋势分析 |
| 19 | TripAdvisor | 酒店、景点、评论、评分 | 旅游、市场研究 |
| 20 | Zillow | 房源、价格、地区信息 | 房地产市场研究 |
其中,TikTok连续第二年保持榜首位置,几乎每五个爬取请求中就有一个指向TikTok。ChatGPT和Perplexity则是首次进入前十——这标志着企业数据采集的焦点已从“追踪搜索结果”转向“监控AI生成的答案”。
二、这些网站为什么成为热门数据源?
不同行业的团队采集数据的目的差异很大,但可以归纳为以下五大类。
1. 搜索数据
典型目标:Google / Bing / Naver
搜索数据一直是爬虫经济的基础。2026年的变化在于,Google搜索结果页的数据提取已不再是一个扁平的链接列表——现在需要覆盖经典搜索结果、AI Overviews、AI模式对话、购物模块和本地结果等多种响应面。SEO团队需要同时追踪传统排名和AI Overview中的引用来源,才能全面了解品牌在搜索生态中的可见度。
Bing在微软于2025年8月关闭官方Search API后,其SERP爬取需求显著上升,第三方爬虫工具成为主要替代方案。
2. 电商数据
典型目标:Amazon / Walmart / Target / eBay
电商数据采集的核心诉求是价格监控、库存追踪和竞品分析。据行业数据,零售和电商占所有网络爬取的36.7%,是最大的行业细分。
Amazon在2026年榜单中虽然从第3位滑落至第8位,但仍是电商领域最重要的数据源。其反爬系统在2026年进一步升级,单会话有效采集量被限制在20-50个产品之间,团队必须精心设计请求节奏和IP轮换策略。Target的首次入榜则反映出零售商在AI驱动购物场景下对产品数据的新需求。
3. 社交媒体数据
典型目标:TikTok / Instagram / Reddit / X
TikTok之所以连续两年位居榜首,与其18%的爬取占比密不可分。企业和开发者从TikTok采集视频元数据、用户互动数据(播放量、点赞、评论、分享)、评论内容乃至TikTok Shop商品信息,用于趋势分析、内容策略制定和带货效果评估。
Instagram和Reddit同样是热门的社媒数据源。Reddit的社区讨论数据被广泛用于消费者洞察和情感分析,而Instagram则是品牌视觉内容监测的核心平台。
4. AI数据(GEO)
典型目标:ChatGPT / Perplexity
这是2026年最具突破性的变化。ChatGPT和Perplexity首次进入最常被爬取网站前五名,催生了一个全新的领域——生成式引擎优化(GEO, Generative Engine Optimization)。
品牌方现在需要监控:ChatGPT在回答中是否提及了自己的品牌?竞品被推荐的频率如何?AI引用了哪些来源页面?这些数据直接影响品牌的AI可见度策略。Perplexity因其在回答中直接引用来源的格式,成为引用追踪的特定目标。
ChatGPT在2026年2月达到9亿周活跃用户,Perplexity的用户基数虽小,但其问答格式使其成为独特的采集标的。
5. B2B数据
典型目标:LinkedIn
LinkedIn是B2B数据采集的核心平台。销售和运营团队通过采集LinkedIn上的职位信息、公司规模、行业分类、总部位置等结构化数据,构建潜在客户列表。
到2026年,LinkedIn数据采集的技术路线已从简单的HTML解析升级为Playwright等浏览器自动化工具配合代理IP池的方案。团队可以通过职位名称、公司、行业、地理位置等多维度筛选,精准定位目标客户群体。
三、网站数据采集面临哪些问题?如何解决?
网站数据采集真正困难的地方,往往不是获取一两个页面,而是在高并发、多地区、长期运行的复杂场景下,如何保障采集链路的稳定与高可用。
以下是数据采集工程中最常见的 6 大核心挑战及对应的解法:
1. IP 限制与风控封禁
目标网站通过IP信誉评分、ASN分析和请求频率来识别和封锁爬虫流量。数据中心IP尤其容易被标记——Amazon等平台的反爬系统能在请求到达后的极短时间内判定来源性质,当大量请求来自同一 IP 时,目标网站风控系统会迅速判定为异常行为并触发拦截。
解决方案: 使用住宅代理IP是当前最有效的应对策略。住宅IP由真实ISP分配给家庭用户,目标网站难以将其与正常用户流量区分开来,例如IPFoxy代理服务提供的住宅IP代理,支持选择目标国家/地区和IP轮换模式(轮换或粘性)并配置到自动化爬取的脚本中,配合合理的并发控制,可显著降低被封禁的概率。
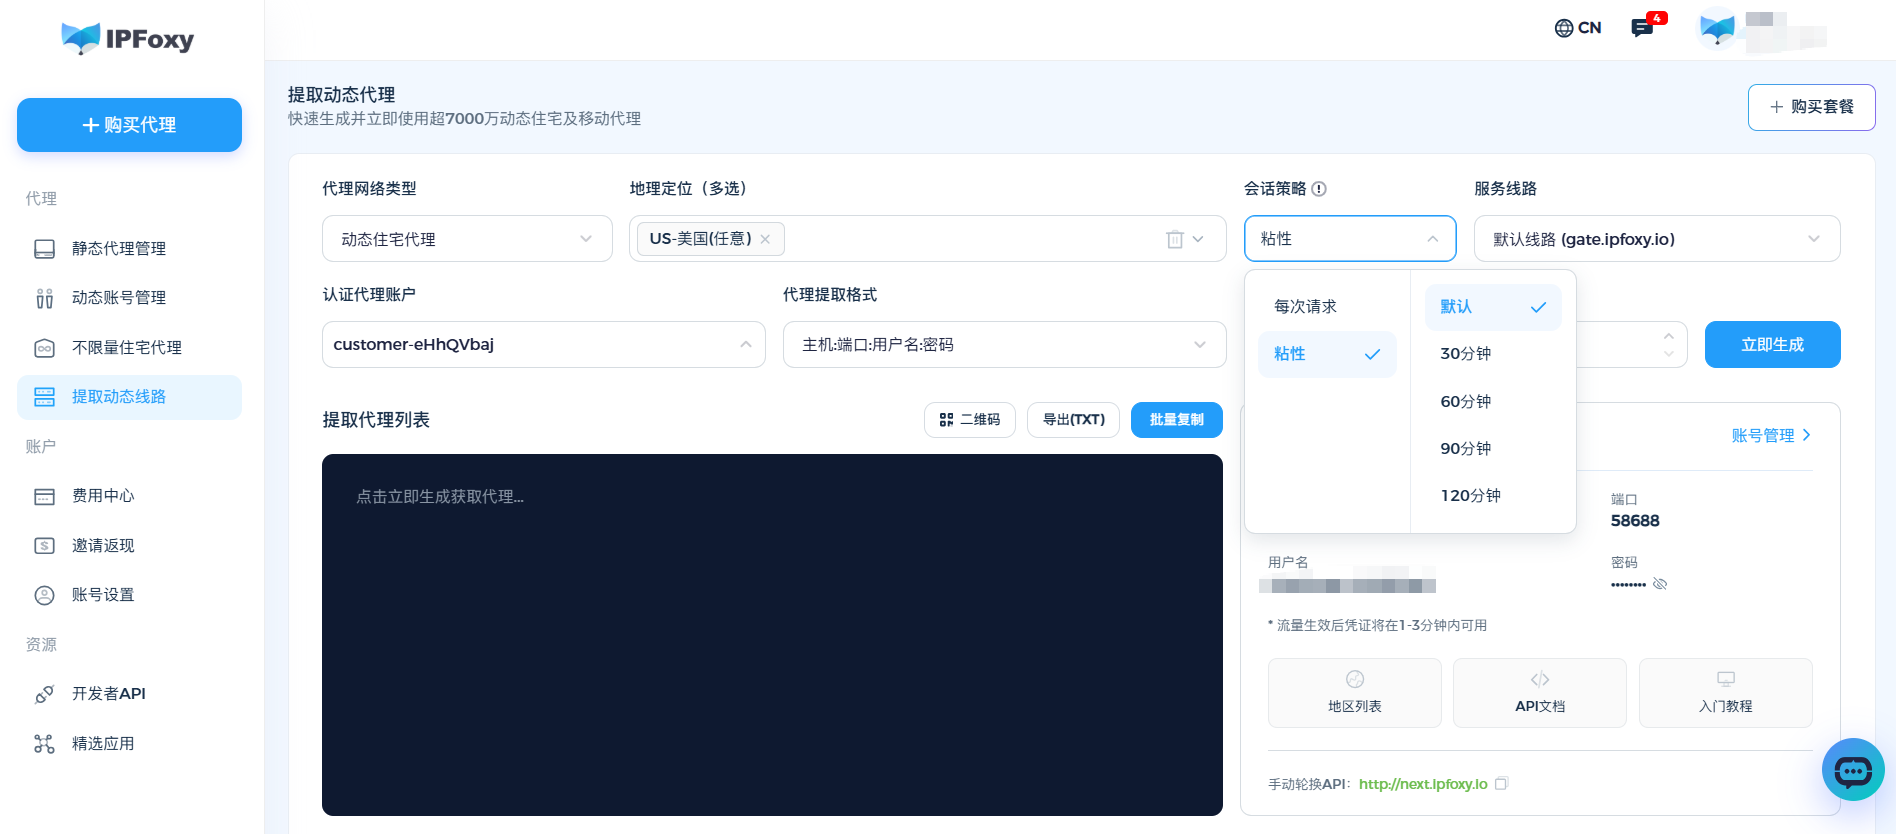
IP代理在此场景下的作用如下:
- IP轮换:通过不同IP发送请求,降低大量请求集中来自单一IP的风险。
- 地区定位:对于Google、TikTok、电商平台等存在地区内容差异的网站,可以根据目标市场选择对应地区的IP。
- Session控制:需要保持登录状态或连续访问时,可以使用粘性会话,需要高频切换则可以每次请求轮换,灵活应对不同场景。
- 并发采集:在需要同时采集多个关键词、页面或数据源时,合理的IP池可以帮助分散请求。
2.请求频率与并发控制
几乎所有主流网站都设置了请求频率阈值。Shopify公开页面的频率限制通常为每秒2-4个请求,Twitter API在2026年进一步收紧了调用间隔。超出限制后,轻则返回429状态码,重则临时或永久封禁IP。
解决方案: 合理设置请求间隔是最基本的应对方式。在爬虫脚本中加入随机抖动(如0.5-2秒的随机延迟),模拟真实用户的操作节奏。更重要的是结合代理IP轮换,将请求分散到大量不同的IP上,使单个IP的请求频率始终保持在安全阈值以内。
3. 地区内容差异与千人千面
Google、TikTok、Amazon等平台会根据访问者的地理位置返回不同的内容和搜索结果。做跨境电商或全球SEO的团队,需要采集特定地区的真实数据。
解决方案: 使用具有地理定位能力的代理IP,将请求出口定位到目标国家或城市。例如IPFoxy动态代理支持按城市级别代理出口,确保采集到的数据与目标市场的真实用户看到的一致。
4. 验证码与反机器人检测
Cloudflare盾、DataDome、PerimeterX等反爬系统会在检测到异常流量时弹出验证码或JavaScript挑战。这些系统不仅分析IP,还会检测浏览器指纹、TLS指纹、Canvas渲染特征等。
解决方案: 仅靠代理IP不足以完全绕过高级反爬系统。推荐的做法是代理IP轮换配合浏览器指纹伪装工具。具体而言,使用puppeteer-extra-plugin-stealth等插件抹平自动化特征,再通过高匿代理IP进行请求轮换,是目前经过验证的有效组合方案。
5.高并发请求管理
当采集规模从几百个页面扩大到数十万甚至百万级时,并发管理成为核心难题。连接池复用、KeepAlive长连接等常规优化手段在代理IP频繁切换的场景下反而可能导致IP切换失效。
解决方案: 采用隧道代理架构进行动态IP轮换,并禁用KeepAlive、动态清空连接池,确保每次请求都能通过新IP发出。IPFoxy住宅代理的不限量模式以时长计费、支持定制带宽且无流量上限,尤其适合大规模数据采集任务
四、FAQ
1.什么是网页抓取Web Scraping?
网页抓取Web Scraping是通过程序自动从网站中提取公开网页数据的技术,常用于市场研究、价格监控、搜索排名分析、竞品研究等场景。
2.为什么ChatGPT和Perplexity开始成为数据采集目标?
企业开始关注AI平台如何回答与品牌、产品和行业相关的问题,因此会分析AI回答、品牌提及和引用来源,这也是GEO逐渐受到关注的原因之一。
3.网页抓取使用什么代理比较合适?
需要根据目标网站和采集场景选择。如果需要模拟真实用户的地区访问,住宅代理IP通常更适合;如果更看重固定IP,可以考虑静态ISP代理;对于大规模、对成本和并发要求较高的任务,则可以根据目标网站情况考虑数据中心代理。
五、结语
2026年的热门数据采集网站已经呈现出明显的多元化趋势。TikTok代表社交媒体和短视频数据,Google代表搜索数据,Amazon和Target代表电商数据,而ChatGPT和Perplexity则代表正在快速发展的AI数据采集。
这意味着Web Scraping已经不再只是传统意义上的“网页爬虫”。对于企业来说,它正在成为市场研究、价格监控、SEO、GEO、竞品分析和数据驱动决策的重要基础设施。
如果需要进行大规模、跨地区的数据采集,除了编写稳定的采集程序,还需要综合考虑IP质量、轮换策略和请求并发等因素。选择合适的代理类型,可以让整个数据采集流程更加稳定,也更适合长期运行。