抓取 YouTube 视频、频道或评论数据时,403、429、CAPTCHA 和内容为空等问题并不少见,其原因往往涉及 IP、请求频率、客户端特征和页面渲染。2026 年,YouTube 自动化访问校验更加复杂,选对抓取方式并优化网络环境,比反复修改代码更重要。本文将从工具选型、反爬机制和报错排查展开分析。
一、YouTube 爬虫怎么选?3 种常见方法对比
YouTube 数据抓取前,先根据目标数据和页面类型选择工具,不同方案的适用范围并不相同:
| 方法 | 适合场景 | 主要优点 | 主要局限 |
| YouTube Data API v3 | 视频、频道、播放列表、评论等结构化数据 | 官方接口,数据结构清晰,稳定性较高 | 有 API 配额和权限限制 |
| yt-dlp | 视频信息、格式、媒体文件等 | 成熟度高,提取逻辑完善,使用灵活 | 受 IP、客户端和 Token 变化影响 |
| Python+浏览器自动化 | 动态页面、JS渲染、复杂交互 | 可模拟完整浏览器流程,扩展性强 | 资源消耗较大,更容易触发反爬 |
如果主要获取视频元数据、频道信息、播放量等标准字段,优先选择 YouTube Data API v3。通过 API Key 或 OAuth 调用资源,不需要解析网页,适合对数据规范性和稳定性要求较高的任务。使用前需要确认 API 权限和配额,批量搜索时尤其要提前计算调用成本。
如果任务涉及视频格式、字幕或媒体文件,可以使用 yt-dlp。它已经封装了 YouTube 的提取逻辑,适合批量获取视频相关数据。实际运行中,如果任务请求量较大或网络环境不稳定,可以根据需要配置代理,保证连接稳定。
当目标内容依赖 JavaScript 渲染、动态加载或页面交互时,再考虑 Selenium、Playwright 等浏览器自动化方案。这类工具能够控制完整的浏览器流程,适合 API 和 yt-dlp 难以处理的网页内容,但资源消耗更高,实际使用时通常也需要配置代理。
二、YouTube 反爬机制是什么?重点看 3 个层面
1. 网络层
网络层主要判断请求的来源和访问规模,重点关注出口 IP、请求频率以及短时间内的访问集中程度,常见检测维度包括以下三个方面:
- IP 来源:判断请求来自数据中心、住宅网络还是其他网络出口
- 访问频率:短时间内集中访问大量视频、频道或搜索结果,会形成明显的机器访问特征
- 请求规模:大量任务共用一个出口时,请求会集中到同一 IP,更容易形成异常访问模式
这一层的核心是判断访问来源是否可信,因此代理 IP 并不只是简单更换一个地址,还涉及出口稳定性、IP 历史信誉和请求规模。对于持续运行的抓取任务,网络环境本身就是反爬检测的一部分。
2. 协议层
协议层主要判断请求是否来自符合要求的客户端,除了 URL 外,YouTube 还会结合 User-Agent、Headers、Cookies、客户端类型以及请求凭证等信息识别请求来源。也就是说,即使 IP 和访问频率正常,如果客户端特征或请求参数不符合预期,也可能无法获取完整内容。
过去部分抓取程序通过模拟常见客户端即可正常获取数据,但这种方式在 2026 年面临更多限制。YouTube 对不同客户端的访问能力进一步细分,PO Token 和 SABR 等变化也影响了部分视频数据的获取方式:
- PO Token:可以理解为 YouTube 用来验证特定请求来源的凭证。部分客户端在请求视频流、播放器或字幕资源时需要提供对应 Token;缺少时可能出现 403,或者直接导致部分格式不可用。
- SABR:YouTube 正逐步在部分客户端采用新的流媒体传输方式。当传统媒体 URL 不再直接提供,而请求转向 SABR 后,原本依赖固定视频 URL 的抓取方式就可能失效。
这意味着现在判断 YouTube 爬虫是否正常,不能只看“浏览器能不能打开网页”,还要看当前客户端采用什么请求方式,以及平台是否要求额外凭证。
3. 行为层
行为层关注的不是某一次请求,而是一段时间内的访问轨迹。例如连续搜索相似关键词、快速打开大量视频、重复请求相同资源、固定间隔批量操作等,都可能形成明显的自动化特征。
这类行为的共同特点是:请求本身可能没有错误,但访问模式明显偏离正常用户。一旦触发进一步验证,就可能出现 CAPTCHA、登录要求、请求限流甚至网页内容异常。
因此,YouTube 的反爬可以理解为三层判断:网络层看来源,协议层看请求,行为层看轨迹。
2026 年的变化在于,平台检测已经不再局限于传统的 IP 和访问频率,而是进一步深入到客户端类型、媒体传输方式和请求凭证。这也是为什么同样的代码,在不同时间、不同客户端或不同网络环境下,可能出现完全不同的抓取结果。
三、YouTube 爬虫常见问题及解决方法
1. IP频繁触发访问限制
如果 YouTube 爬虫需要持续访问大量视频、频道或评论数据,首先要考虑代理 IP 是否适合当前任务。下面是常见爬虫IP类型:
- 动态住宅代理:适合批量数据采集、关键词搜索、评论抓取等请求量较大的任务,通过轮换出口 IP 分散访问压力,降低单一 IP 持续高频请求的风险。
- ISP 代理:适合频道监控、账号相关数据采集和持续运行的爬虫,需要长期保持相对稳定的网络身份时更合适。
实际选择可以使用IPFoxy提供的住宅代理,相比于数据中心代理,这类代理更接近真实用户网络的出口特征,在对 IP 来源和信誉较敏感的 YouTube 数据抓取场景中更合适。同时,根据任务选择动态住宅或 ISP 代理,让不同任务使用更匹配的网络出口,再配合合理的请求频率和并发控制,降低请求集中导致的不稳定和访问限制。
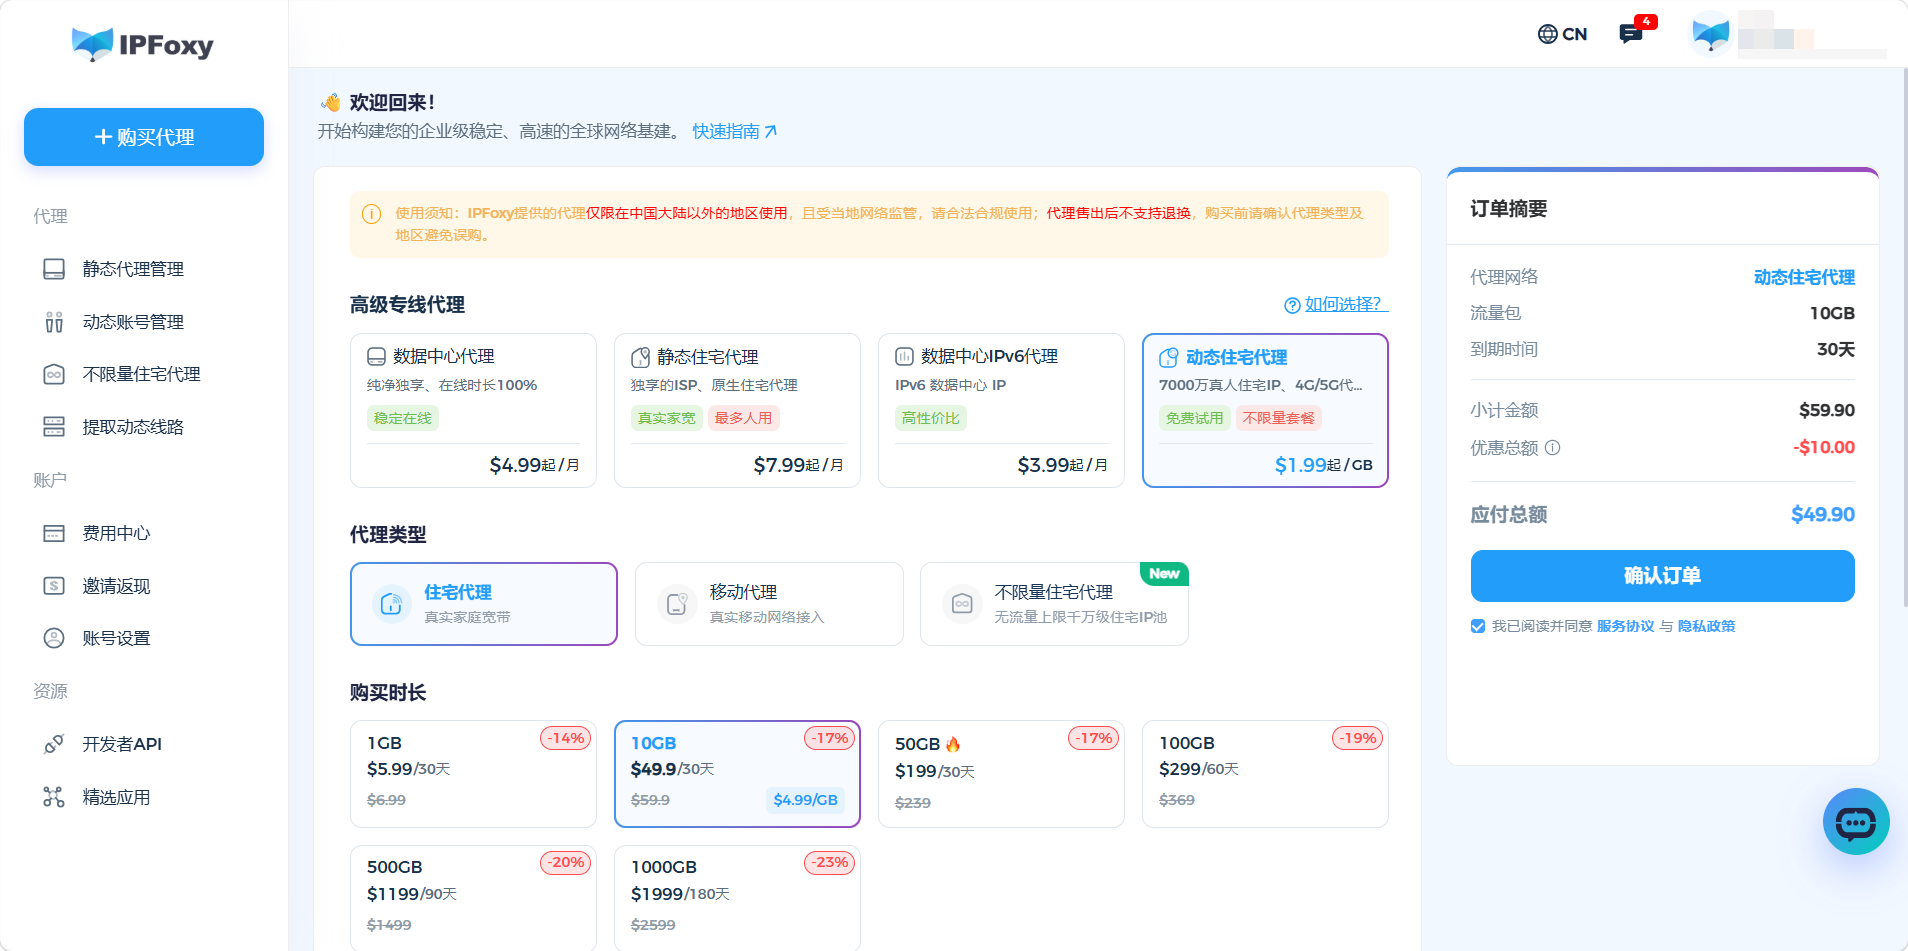
如果已经出现 429 或 CAPTCHA,应先暂停异常任务,降低请求频率和并发量,避免持续重试。对于请求量较大的任务,还可以通过代理轮换和任务队列分散访问,降低请求集中带来的限制风险。
2. 多频道连续异常
如果同时抓取多个频道、关键词或数据类型,并出现多个任务连续异常,应先检查是否共用了相同的 IP 和运行环境。多个任务长期集中在同一出口,可能导致请求相互叠加,一个任务出现异常后也可能影响其他任务。
处理时,可以按照任务类型划分独立环境,将上述IPFoxy 提供的代理分别配置到对应的浏览器、脚本或自动化工具中,让不同任务使用相对独立的网络出口和运行环境。这样既能减少不同任务之间的相互影响,也方便出现异常时快速定位具体任务和网络环境。
3. SSL: UNEXPECTED_EOF
如果出现 SSL: UNEXPECTED_EOF,通常代表 TLS 连接在完成前被异常关闭,不一定是 YouTube 反爬导致。也有可能是代理节点不稳定、网络中断或 TLS 连接兼容性问题,这些都可能产生类似报错。
可以先进行直连和代理连接对比。如果仅使用代理时出现错误,应优先更换节点或检查代理协议和连接稳定性;如果直连同样异常,再进一步排查本地网络和运行环境。
4. 网页大面积返回403
如果几乎所有请求都返回 403,不要直接判断为 IP 被封。使用 yt-dlp 时,应先检查版本和当前客户端适配情况,再确认 Cookies、客户端类型以及相关请求凭证是否正常。部分 YouTube 客户端涉及 PO Token 时,缺少必要凭证也可能导致部分内容或格式不可用。
如果使用 YouTube Data API,则需要单独检查 API Key、OAuth 权限和 API 配额。例如 quotaExceeded 属于接口配额问题,与网页抓取中的 IP 反爬并不是同一类原因。
5. 返回 200 但内容为空
HTTP 200 只代表服务器成功返回了内容,并不意味着已经获取到目标数据。如果返回的是 Consent 页面、登录页面或依赖 JavaScript 加载的页面,程序同样可能得到 200,但无法解析出视频或频道数据。
遇到这种情况,应先检查实际返回的 HTML,确认是否包含目标字段。如果是 Consent 或登录页面,需要检查 Cookies、地区和会话状态;如果目标数据依赖 JavaScript 动态加载,则应改用能够执行页面渲染的浏览器自动化方案。
四、FAQ
YouTube 爬虫优先用 API 还是网页抓取?
结构化的视频、频道、播放列表数据,优先使用 YouTube Data API;需要页面动态内容或 API 无法提供的数据,再考虑 yt-dlp 或浏览器自动化。
yt-dlp 和 Selenium、Playwright 有什么区别?
yt-dlp 更适合视频信息、字幕和媒体文件获取;Selenium、Playwright 更适合 JavaScript 渲染、页面交互和动态内容抓取。
YouTube 爬虫一定需要代理吗?
低频测试不一定需要。批量采集、长期运行或多任务并行时,代理可以提供独立网络出口,便于任务隔离和访问管理。
五、总结
YouTube 数据抓取遇到 403、429 或内容为空时,不要简单归因于反爬。应先判断工具和任务类型,再检查网络环境、请求配置和页面状态。长期运行还要保持网络稳定、请求节奏合理,并做好不同任务的环境隔离,才能提高数据抓取的稳定性。