网页抓取(Web Scraping)是获取公开网页数据的常见方式,广泛应用于商品价格监控、竞品分析、SEO研究和市场数据采集等场景。而在众多网页抓取工具中,cURL凭借轻量、灵活、支持多种HTTP请求方式等特点,成为开发者常用的命令行工具之一。
使用cURL,开发者可以直接发送HTTP请求,获取网页HTML或JSON数据,还能自定义请求头、配置代理IP,并结合Python实现批量数据采集。
那么,如何使用cURL进行网页抓取?本文将从环境准备开始,通过实际操作介绍cURL网页抓取的完整流程、常见问题及解决方法。
一、什么是cURL?为什么可以用于网页抓取?
cURL是一款通过URL传输数据的命令行工具,支持HTTP、HTTPS等多种网络协议。开发者可以通过终端向网站发送请求、查看服务器响应,并将获取的数据保存到本地。
在Web Scraping场景中,cURL主要负责获取网页HTML或API返回的数据,再配合其他工具完成内容解析与存储。
使用cURL进行网页抓取具有以下优势:
- 轻量易用: 无需启动浏览器,通过简单命令即可获取网页内容。
- 请求控制灵活: 支持GET、POST、自定义请求头、Cookie及身份认证。
- 便于自动化: 可以结合Shell脚本和Python,实现批量网页采集。
- 支持代理配置: 可通过HTTP(S)或SOCKS5代理管理请求的网络出口。
不过,cURL本身不会像浏览器一样执行JavaScript。如果目标网页依赖JavaScript动态加载内容,可能需要使用网站提供的API,或结合Playwright、Selenium等浏览器自动化工具。
二、cURL网页抓取前的准备:安装工具与配置代理IP
正式开始网页抓取前,需要先确认cURL运行环境,并根据采集需求配置网络连接。尤其是涉及多地区数据采集、商品价格监控或长期自动化任务时,提前配置代理IP,有助于统一管理请求出口,减少后续反复修改脚本的工作。
1. 检查并安装cURL
cURL支持Windows、macOS和Linux系统。打开终端或命令提示符,输入:
curl --version
如果返回版本信息,说明cURL已经安装成功。如果系统未安装,可以前往cURL官网下载对应版本。
Windows PowerShell用户可以使用curl.exe --version,避免旧版本PowerShell中的命令别名冲突。
2. 为什么cURL网页抓取需要配置代理IP?
对于简单的网页测试,直接使用本地网络即可。但在实际Web Scraping任务中,开发者可能需要获取不同地区展示的公开数据,或统一管理多个采集任务的网络出口。
例如,电商网站可能根据访问地区展示不同的商品价格、货币和库存信息。使用目标地区的代理IP,可以帮助开发者测试不同网络位置下的页面响应。
对于这类需求,可以选择IPFoxy动态住宅代理。IPFoxy提供覆盖200多个国家和地区的住宅代理资源,支持HTTP(S)、SOCKS5协议,以及国家、州、城市等地区定向功能,适用于多地区公开数据采集、价格监控和市场研究等场景。
3. 如何在cURL中配置IPFoxy代理?
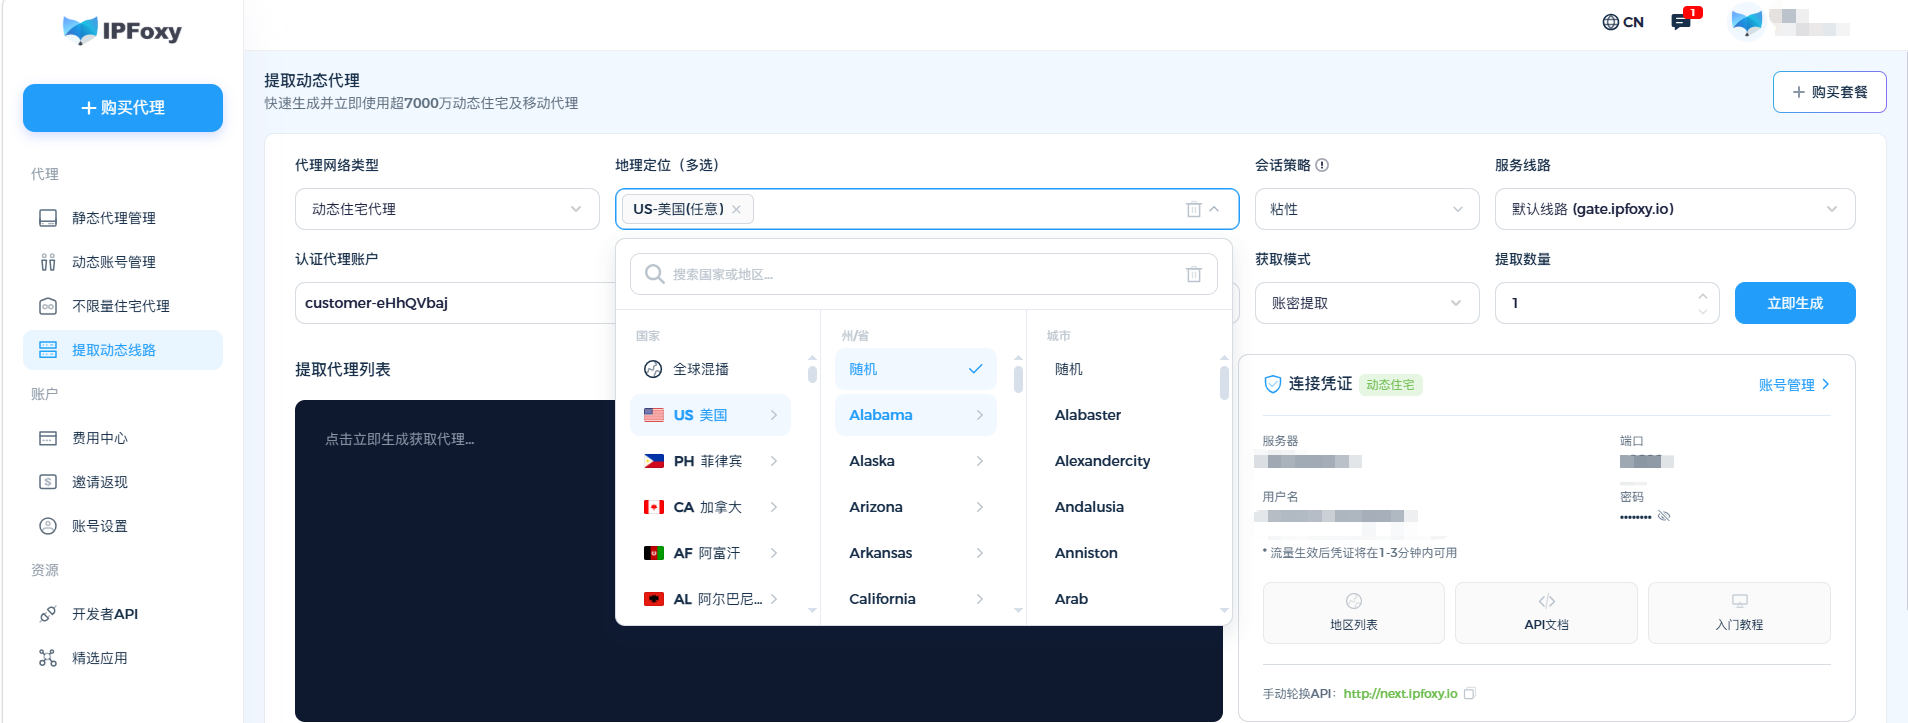
第一步:获取代理连接信息
进入IPFoxy登录账号,选择动态住宅代理并生成动态代理线路,根据业务需求设置目标国家、地区和火花轮换策略,获取代理服务器地址、端口、用户名和密码。
第二步:配置代理信息并检测连接
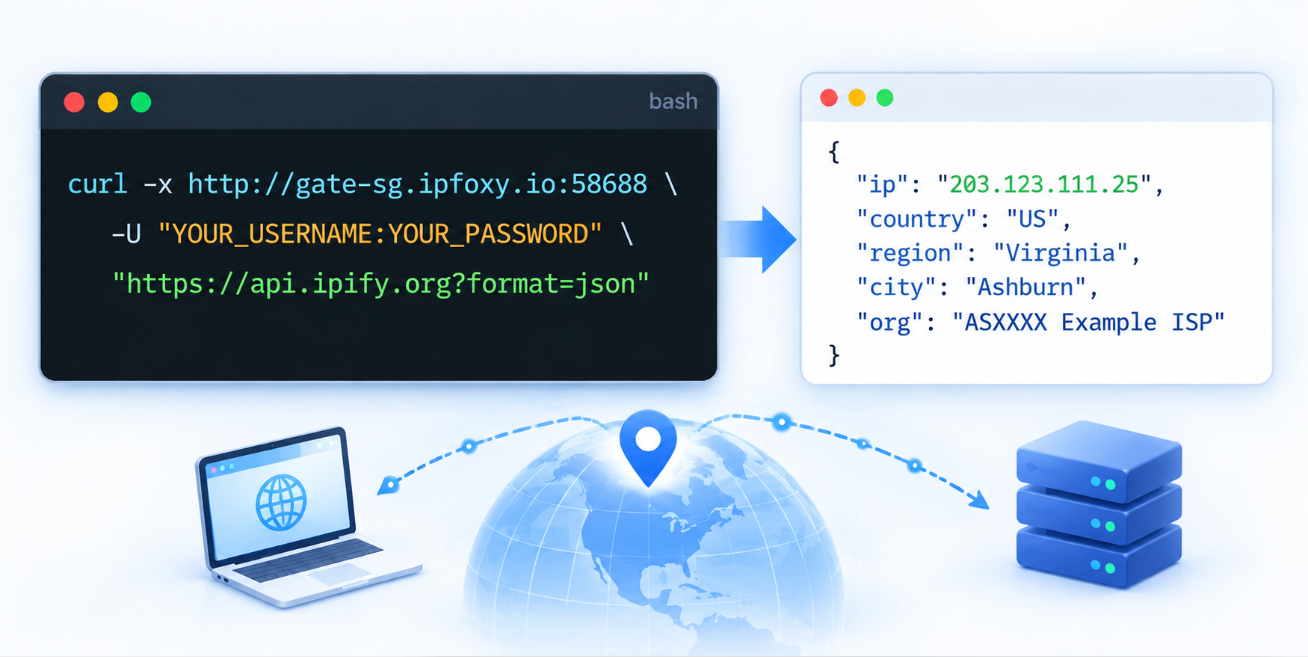
cURL可以通过-x参数指定代理服务器,使用-U参数进行代理认证。
curl -x http://gate-sg.ipfoxy.io:58688 \
-U "YOUR_USERNAME:YOUR_PASSWORD" \
"https://api.ipify.org?format=json"
将用户名和密码替换为IPFoxy控制台生成的实际连接信息。如果成功返回出口IP地址,说明代理连接正常。
完成配置后,即可在后续网页抓取命令中使用相同的代理连接参数,通过指定网络出口发送请求。
需要注意,代理IP主要用于管理网络出口和地区访问环境,不能替代网站授权,也不意味着可以绕过目标网站的访问限制。
三、cURL网页抓取实战教程:从HTTP请求到数据提取
下面以专门用于爬虫练习的Quotes to Scrape网站为例,演示如何使用cURL获取网页内容、提取数据,并将结果保存为CSV文件。
以下Shell命令适用于macOS、Linux及支持Bash的终端环境。Windows用户可以使用WSL或Git Bash执行。
1. 使用cURL发送GET请求获取网页HTML
GET是最常见的HTTP请求方式,可以直接获取目标网页的HTML内容。
curl https://quotes.toscrape.com/
执行后,终端会显示服务器返回的HTML源码,包括页面标题、文本内容和HTML标签。
如果目标网站存在重定向,可以添加-L参数,让cURL自动跟随HTTP重定向。
2. 保存网页内容并检查响应状态
实际数据采集时,通常需要将HTML保存到本地,以便后续解析。
curl -L --fail \
-o page.html \
-w "%{http_code}\n" \
https://quotes.toscrape.com/
其中:
- -L:自动跟随HTTP重定向。
- --fail:在大多数HTTP 400及以上错误响应时返回失败状态。
- -o:将网页内容保存为指定文件。
- -w:输出HTTP状态码,便于检查请求结果。
当返回200时,通常表示HTTP请求成功,但仍需要检查响应内容是否符合预期。
如果需要通过IPFoxy代理抓取,只需在命令中加入前面介绍的-x和-U参数。
3. 自定义请求头获取网页内容
部分网站会根据HTTP请求头返回不同内容。cURL支持通过-H添加请求头,通过-A设置User-Agent。
curl -L https://quotes.toscrape.com/ \
-A "MyScraper/1.0" \
-H "Accept: text/html"
其中,User-Agent用于标识请求客户端,Accept用于说明希望接收的内容类型。
对于需要身份认证的网站,cURL还支持Cookie和其他认证参数,但应确保拥有合法的访问权限。
4. 使用cURL获取JSON API数据
除了HTML网页,cURL也可以直接请求API并获取JSON数据。
例如,使用公开测试API:
curl -s https://jsonplaceholder.typicode.com/posts/1
执行后,服务器会返回包含文章ID、标题和正文等字段的JSON数据。
如果系统安装了jq,还可以直接提取指定字段:
curl -s https://jsonplaceholder.typicode.com/posts/1 | jq -r '.title'
相比解析复杂的HTML结构,直接处理JSON通常更加高效,因此在目标网站提供合法API时,可以优先考虑这种方式。
5. 批量抓取分页并提取数据
掌握单页抓取后,可以通过Shell循环批量下载多个页面。
例如,抓取Quotes to Scrape网站的前三页:
for page in 1 2 3
do
curl -L --fail \
"https://quotes.toscrape.com/page/$page/" \
-o "page_$page.html"
sleep 2
done
该脚本会依次下载三个页面,并在请求之间暂停2秒。实际任务中,应根据目标网站的访问规则设置合理的请求频率。
完成下载后,可以结合Python和BeautifulSoup提取网页中的名言及作者信息。
首先安装解析库:
pip install beautifulsoup4
然后创建parse.py文件,输入:
from bs4 import BeautifulSoup
import csv
import glob
with open("quotes.csv", "w", newline="", encoding="utf-8") as f:
writer = csv.writer(f)
writer.writerow(["Quote", "Author"])
for filename in sorted(glob.glob("page_*.html")):
with open(filename, encoding="utf-8") as html:
soup = BeautifulSoup(html.read(), "html.parser")
for item in soup.select(".quote"):
quote = item.select_one(".text").get_text(strip=True)
author = item.select_one(".author").get_text(strip=True)
writer.writerow([quote, author])
print("数据已保存至 quotes.csv")
运行python parse.py后,程序会读取已下载的HTML文件,提取名言和作者信息,并统一保存到quotes.csv。
至此,就完成了从cURL发送请求、批量下载网页,到Python解析HTML并导出CSV的完整网页抓取流程。
四、cURL网页抓取常见问题及解决方法
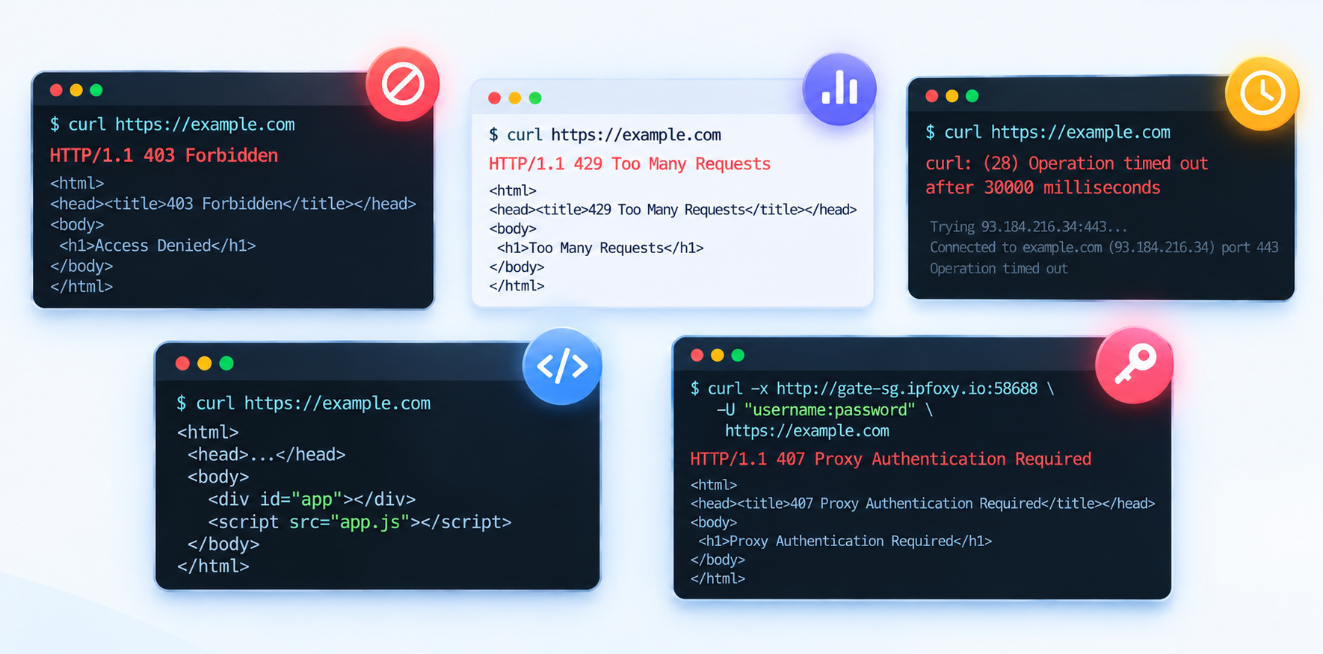
在使用cURL进行网页抓取时,可能遇到请求失败、连接超时或数据不完整等问题。以下是5种常见情况及对应的解决方法。
1. cURL返回403 Forbidden
403表示服务器理解了请求,但拒绝提供资源。常见原因包括访问权限不足、身份认证失败或网站访问策略限制。
解决方法: 检查目标网页是否允许自动化访问,确认请求头、登录凭据和访问权限是否正确。如果网站明确限制访问,应遵守相关规则,而不是反复发送请求。
2. cURL返回429 Too Many Requests
429表示请求频率超过服务器允许的限制,通常出现在短时间内连续抓取多个页面的场景。
解决方法: 降低请求频率,在批量采集脚本中设置合理的请求间隔,并遵循服务器返回的Retry-After要求。对于持续运行的任务,可以增加指数退避机制,避免重复触发限流。
3. cURL连接超时或请求失败
网络连接不稳定、服务器响应缓慢或代理连接异常,都可能导致cURL请求超时。
解决方法: 先检查目标网站和本地网络是否正常,再根据需要设置连接超时与重试参数,例如使用--retry 3、--connect-timeout 10和--max-time 30,分别控制重试次数、连接超时和单次请求总时长。
4. cURL抓取的HTML内容不完整
部分网站使用JavaScript动态加载商品信息、评论或其他页面内容。由于cURL不会执行JavaScript,即使请求成功,也可能无法获取完整数据。
解决方法: 优先检查网站是否提供允许使用的数据API。如果数据必须通过浏览器渲染才能获取,可以考虑使用Playwright或Selenium等浏览器自动化工具。
5. cURL代理连接失败
配置代理后,如果出现连接失败、407 Proxy Authentication Required或无法获取网页内容,可能是代理服务器地址、端口、协议或认证信息配置错误。
解决方法: 检查代理地址、端口、用户名和密码是否与IPFoxy控制台提供的信息一致,并确认HTTP或SOCKS5协议配置正确。可以先通过IP检测接口测试代理连接,再排查目标网站的响应问题。
五、总结
cURL是一款轻量、灵活的网页抓取工具,适合获取HTML、请求JSON API及执行简单的自动化数据采集任务。结合Shell脚本和Python,还可以实现分页抓取、内容解析与CSV数据导出。
对于多地区公开数据采集任务,可以提前配置IPFoxy住宅代理,统一管理请求的网络出口,并结合合理的请求频率、超时设置和错误处理机制,提高采集流程的稳定性。
需要注意,cURL不具备JavaScript渲染能力。对于复杂动态网页,可以根据实际需求结合Playwright、Selenium等工具,选择更适合的数据采集方案。