在做 SEO 排名监控、竞品分析、关键词研究或本地化搜索分析时,经常需要批量获取 Google 搜索结果。但手动查询效率很低,因此会涉及 SERP 数据采集。本文将全面介绍 SERP 采集的核心数据类型、常见实现方法,以及在批量采集时如何正确配置代理 IP 与请求参数,帮你高效构建稳定的采集流程。
一、什么是 SERP 数据采集?
SERP(Search Engine Result Page)数据采集,是指通过自动化程序提取 Google 等搜索引擎针对特定关键词返回的搜索结果数据。通过对 SERP 抓取,你可以快速获取标准化的 Google 搜索结果数据,用于多维度的业务分析。
可以采集的数据包括:
- 自然搜索结果及排名(Organic Rankings)
- 网页标题、URL、元描述(Description)
- 精选摘要(Featured Snippet)
- 大家还在问(People Also Ask / PAA)
- 相关搜索(Related Searches)
- 图片/视频结果
- Google Shopping 等特殊搜索结果
- 不同国家和地区的 SERP 数据
常见应用场景:
- SEO 关键词排名监控: 批量查看目标关键词排名及排名变化。
- 竞争对手 SERP 分析: 分析哪些网站持续占据目标关键词前列。
- 关键词与内容研究: 从 Related Searches、PAA 等位置发现新的搜索需求。
- 不同地区 SERP 分析: 对比美国、日本、英国等市场的 Google 搜索结果差异。
- 市场与舆情监测: 了解特定品牌、产品或行业趋势在搜索引擎上的曝光度。
- AI & 大模型数据供给: 为 RAG(检索增强生成)系统或行业大模型提供最新的外部检索上下文。
二、SERP数据采集有什么方法?
不同团队的技术储备和采集规模不同,适合的方法也不一样。下面这张表可以帮你快速判断:
| 方法 | 上手难度 | 灵活性 | 适合场景 |
| 手动采集 | 低 | 低 | 少量关键词 |
| SERP API | 低 | 中 | 快速获取结构化数据 |
| Python 爬虫 | 中 | 高 | 自定义数据采集 |
| Playwright / Puppeteer | 中高 | 高 | 浏览器自动化采集 |
手动采集只适合偶尔查看几个关键词;SERP API 省去了维护代理和解析页面的麻烦,但成本随查询量上升;Python 爬虫和浏览器自动化则更适合需要深度定制、长期采集的团队。无论选哪种方式,只要涉及批量请求,代理 IP 都是绕不开的一环。
三、如何采集Google SERP数据?
下面以自建采集流程为例,拆解五个关键步骤。
第一步:确定需要采集的 SERP 数据
动手写代码之前,先想清楚要抓哪些字段。字段设计得越清晰,后续存储和分析越省事。一个常见的 SERP 数据字段结构如下:
例如:
Keyword → Rank → Title → URL → Description → SERP Features → Location → Date
举个例子,采集“best running shoes”在美国地区的 Google 搜索结果,整理后大致是:
| Keyword | Rank | Title | URL | Description | SERP Features | Location | Date |
| best running shoes | 1 | 10 Best Running Shoes... | example.com | ... | Featured Snippet, PAA | US | 2025-03-21 |
除了自然结果,也可以把 Featured Snippet、People Also Ask 等模块单独记录,方便后续分析搜索意图和内容缺口。
第二步:配置反爬代理 IP与 Request Header
这一步是 SERP 采集能否成功的绝对关键。Google 对自动化请求的识别非常成熟,以下情况很容易触发风控:
- 单一 IP 短时间产生大量请求
- 请求频率异常
- 同一 IP 查询大量不同关键词
- 地理位置与目标 SERP 不匹配
- Session / Cookie 管理不合理
- 自动化请求与正常访问行为差异较大
一旦触发,轻则返回 HTTP 429,重则弹出验证码、请求失败,甚至拿到不完整的搜索结果。所以需要配置代理 IP,把请求分散到不同 IP 上,同时借助代理实现不同国家和地区的 SERP 采集。
使用高质量代理住宅代理IP服务是基础。例如用过脚本配置IPFoxy 提供的动态 / 静态代理,可以构建高质量的真实IP轮换池,将请求分散到全球数十万个真实节点上,避免单个 IP 请求频次过高被封禁。
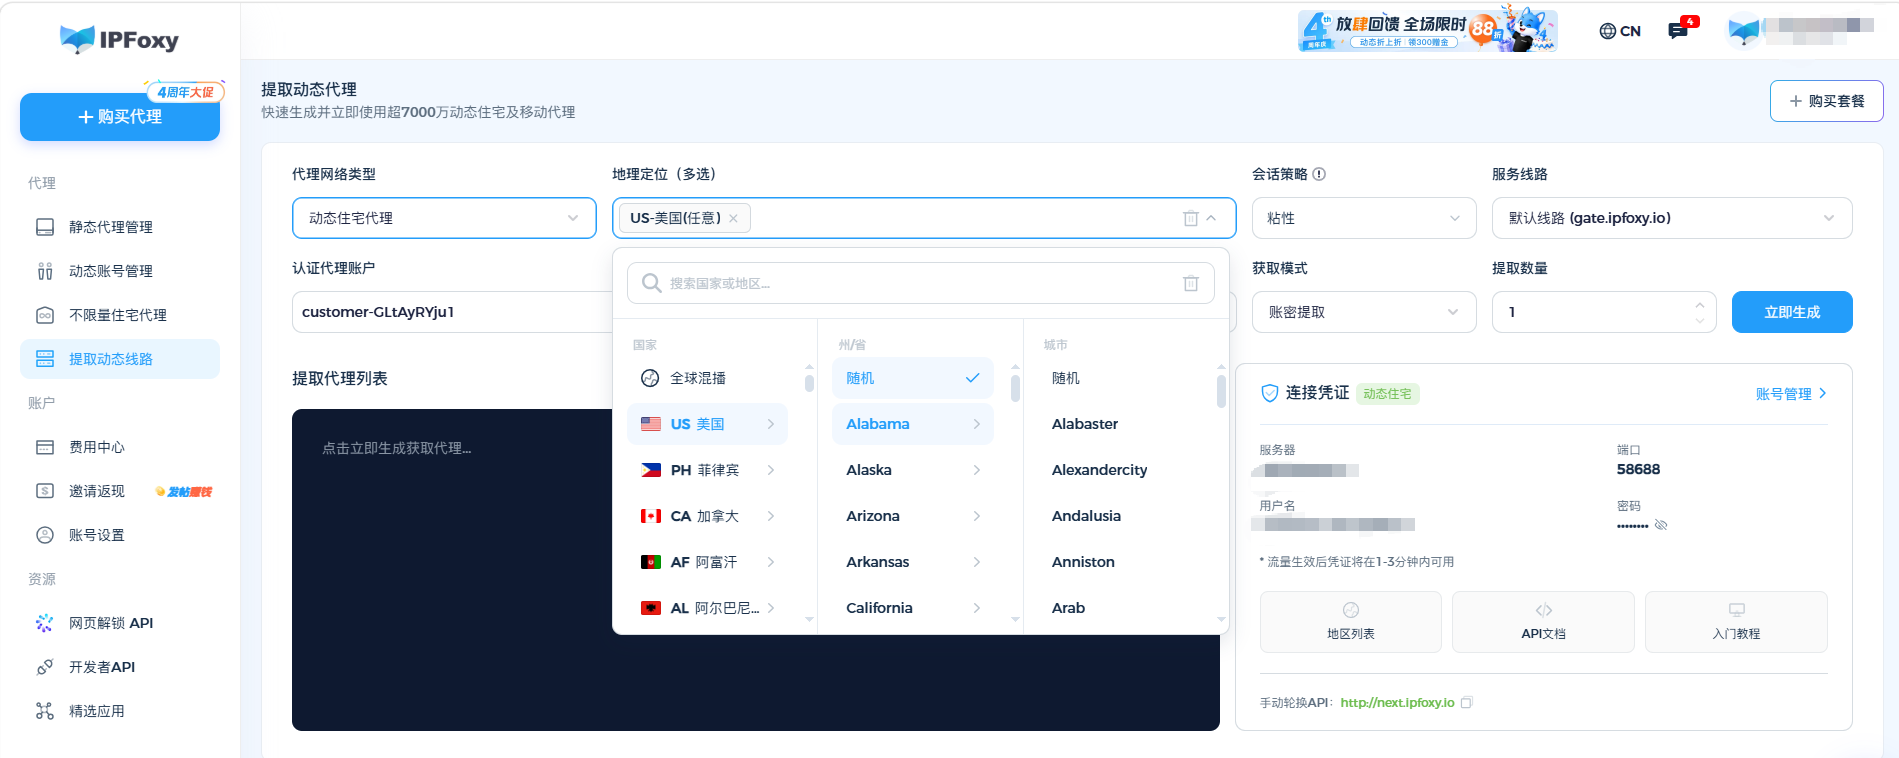
在 Python 中配置代理 IP 的简短示例:
除了代理,还要注意两点:
- 地理定位测试:搭配 IPFoxy 的指定国家 / 城市节点,可以精准采集特定地域的 SERP 结果。比如要抓日本市场的排名,就选日本节点,并设置 gl=jp。
- 伪造 Request Headers:确保每个请求随机携带真实的 User-Agent、Accept-Language、Sec-Ch-Ua 等指纹信息,避免所有请求头完全一致。
第三步:构建 Google 搜索请求
Google 搜索请求的参数会直接影响返回结果。常用的参数包括:
- q:关键词
- gl:国家/地区(如 us、jp、uk)
- hl:语言(如 en、ja)
- num:每页结果数量
- start:分页偏移
- device:设备类型(可通过 User-Agent 模拟桌面或移动端)
如果要做分页采集,第二页可以把 start 设为 10 或 20,具体取决于 num 的设置。注意 Google 对分页深度也有限制,过深的分页往往返回重复或不完整的结果。
第四步:获取并解析搜索结果
可以通过 Python Requests 或浏览器自动化工具获取页面,再解析需要的字段。由于 Google 现在要求 JavaScript 渲染,更推荐使用 Playwright 等工具,否则 Requests 拿到的可能是空壳页面。
以下是一个简单的 Python SERP 数据采集代码示例(使用 Playwright + 代理):
解析时可根据实际 DOM 结构调整选择器。如果使用 Requests,则需注意 Google 可能返回不含完整结果的页面。
第五步:保存和整理SERP数据
采集完成后,建议按结构化格式进行持久化存储:
- 轻量分析: 定期导出为 CSV 或 Excel 文件,方便直观对比。
- 长期监控: 存入 MySQL、PostgreSQL 或 MongoDB 等数据库,建立基于 Keyword + Date + Location 的索引,用于绘制排名趋势图表。
四、SERP 数据采集常见问题
1、SERP 数据采集出现验证码怎么办? 降低请求频率,更换代理 IP,并确保 Request Headers 与真实浏览器一致。使用住宅代理可以显著减少验证码触发概率。如果某个 IP 已经触发验证码,不要继续硬跑,直接切换。
2、SERP 采集出现 429 怎么办? 429 表示请求过多。应减少并发,增加请求间隔,并轮换 IP。避免在短时间内用同一 IP 查询大量关键词。可以给每个 IP 设置请求配额,达到上限就自动切换。
3、为什么不同地区采集到的 Google 排名不一样? Google 会根据用户的地理位置、语言、设备等因素个性化搜索结果。要获取特定地区的真实排名,必须使用该地区的代理 IP,并设置对应的 gl、hl 参数。否则你拿到的可能只是本地视角的排名,无法反映目标市场的真实情况。
总结
SERP 数据采集可以通过 SERP API、Python 爬虫或 Playwright/Puppeteer 等方式完成。当涉及多关键词、多地区数据采集时,需要同时考虑请求频率限制、IP 封禁、Session 管理以及地理位置定位。
如果需要采集不同国家和地区的 SERP 数据,可以根据目标市场选择对应地区的 IPFoxy 代理资源,构建高效稳定的自动化采集基础设施。